Qwen3.8-27B · RTX 5090 Runtime Recipe
RTX 5090 32GB 한 장으로 Qwen3.8-27B를 돌리는 재현 가능한 레시피입니다. 세 가지 런타임을 워크로드별로 측정했고, 모든 벤치마크 데이터와 실행 조건을 함께 공개합니다.
연구 질문
밀집(dense) 27B 모델을 단일 32GB RTX 5090에서 인터랙티브한 속도로 실행할 수 있을까요? 워크로드에 가장 잘 맞는 런타임은 무엇일까요? 원시 디코드 처리량과 에이전트 처리량은 다르기 때문에, 합성 벤치마크에서 앞선 런타임이 실제 자율 실행에서는 더 느릴 수 있습니다.
환경
워크스테이션 GPU 한 장을 사용합니다. RTX 5090의 보고된 VRAM은 32,607 MiB이며 한 번에 생성 런타임 하나와 요청 하나만 GPU에서 실행합니다. 모든 서빙은 루프백 전용(127.0.0.1)이고 외부 클라우드 API에 의존하지 않으며, 저장소에는 수정된 모델 가중치가 없습니다.
런타임 접근
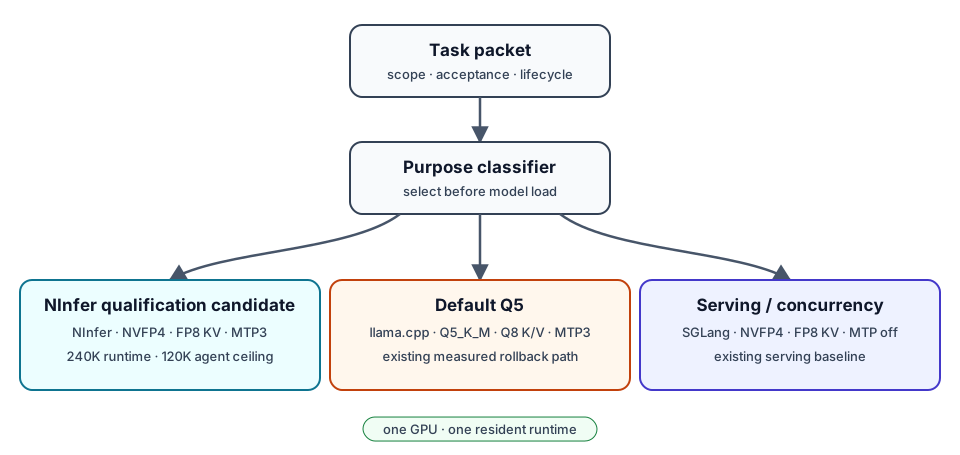
고정된 세 추론 백엔드를 워크로드 인식 작업 라우터 뒤에 배치했습니다. 라우터는 이전 런타임을 종료·정리한 뒤 워크로드 클래스에 맞는 루프백 백엔드 하나만 시작합니다. 기본 단일 에이전트 런타임은 llama.cpp Q5_K_M + MTP3, 고동시성 서빙 기준은 SGLang NVFP4, 자격 검증 후보는 NInfer NVFP4 + FP8 KV + MTP3입니다.
측정 결과
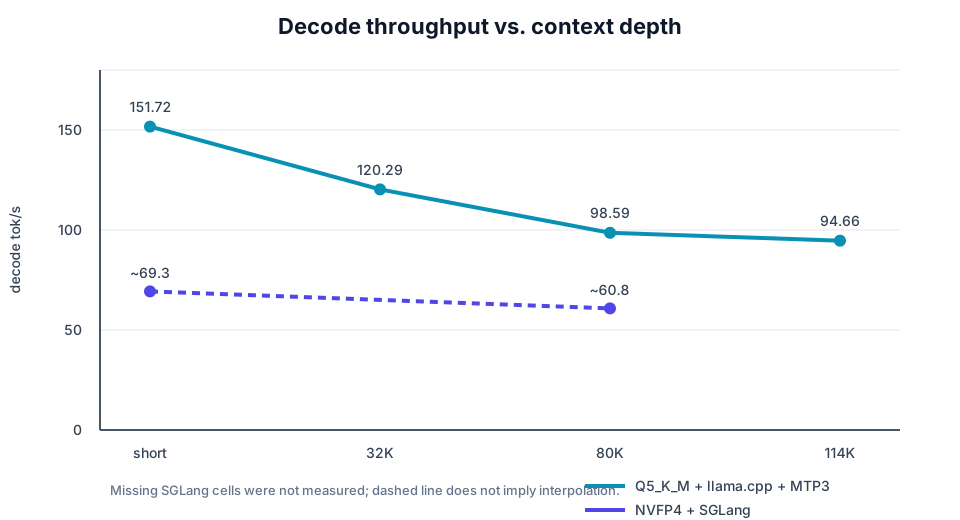
측정값은 런타임·아티팩트·컨텍스트·워크로드와 함께 공개됩니다. SGLang NVFP4는 짧은 컨텍스트에서 약 69.3 tok/s, 80K+ 컨텍스트에서 약 60.8 tok/s를 기록했습니다(43개 샘플의 중앙값). llama.cpp Q5_K_M + MTP3는 짧은 컨텍스트부터 32K, 80K, 113.9K까지 151.72 / 120.29 / 98.59 / 94.66 tok/s를 기록했습니다. 실제 100K+ 자율 코딩 실행(CourseBench 롱 태스크, 2026-08-19 재검증)에서는 최대 관찰 컨텍스트 106,829 토큰에서 평균 109.51 tok/s, 투기적 수용률 89.61%, 피크 VRAM 28.63GB를 기록했습니다.
해석
데이터상 모든 워크로드에서 앞서는 런타임은 없습니다. Q5/MTP3는 제한된 실행에서 약 1.5–2배 빠르게 디코딩하고, SGLang은 80K+ 컨텍스트에서 안정적인 동시 서빙을 제공합니다. 정확성 게이트는 SGLang과 Q5 런타임 모두 통과했습니다: 기본 6/6, JSON 스키마 20/20, 도구 호출 40/40, NIAH 32K/80K/113K+ 각 5/5, CUDA/OOM/출력 손상 이벤트 0건입니다. 핵심은 원시 디코드 TPS를 에이전트 처리량과 같은 의미로 볼 수 없다는 점입니다.
아직 미해결인 부분
최종 프로덕션 속도 순위는 여러 시드에서 엔드투엔드 경과 시간을 비교 측정해야 확정할 수 있어 아직 정해지지 않았습니다. 2026년 9월 NInfer 측정 비교를 완료하고 Codex 실패를 문서화했으며, 이 비교가 끝날 때까지 Q5를 기본 단일 에이전트 런타임으로 유지합니다.
재현하기
레시피 저장소는 전체 벤치마크 매트릭스, 컨텍스트별 값, 재현 가이드, 공개 가이드를 제공합니다. 모델 아티팩트는 공개된 SHA-256 체크섬으로 고정한 업스트림 리비전을 참조하며, 재현하려면 Hugging Face에서 모델을 다운로드해야 합니다. Hugging Face 쇼케이스 공간도 제공하며 저장소 README에서 연결합니다.