Pesquisa e código aberto

Exploração aberta.
Produtos melhores.

Investigamos as questões por trás de produtos e ferramentas de produção melhores. Conheça os conceitos e métodos da nossa pesquisa de IA especializada, além de experimentos públicos e ferramentas de código aberto.

IA especializada · Pesquisa aplicada

O que torna uma IA especializada confiável?

Pesquisamos especialistas de IA que trabalham com conhecimento de domínio e evidências. Nossos experimentos conectam recuperação de documentos e código, treinamento e inferência de modelos e ferramentas de avaliação, documentando melhorias e limites de falha.

Pesquisa interna em andamento · Conceitos e métodos compartilhados publicamente

  1. 01Pergunta do domínio
  2. 02Evidências e exemplos
  3. 03Experimentos de treinamento e inferência
  4. 04Avaliação com casos reservados e verificações de regressão

Conhecimento de domínio fundamentado em evidências

Até onde podemos rastrear as evidências por trás de uma resposta?

Estudamos a recuperação de documentos e código, conferindo as citações com suas fontes. O conhecimento que muda permanece acessível pela recuperação, com tratamento explícito de evidências ausentes e ações arriscadas.
Aprender e transferir habilidades especializadas

Fluxos de diagnóstico aprendidos conseguem preservar um julgamento sólido?

Revisamos exemplos estruturados gerados por modelos professores e experimentamos o ajuste fino e a destilação de modelos alunos. Separamos os dados de treinamento e avaliação, com comparações antes e depois do treinamento e entre formatos de implantação.

Avaliação que revela falhas

Uma aparente melhoria introduz novas falhas?

Casos reservados, contraexemplos e verificações de regressão examinam a precisão das evidências e o tratamento da incerteza. Nossos métodos impedem a promoção de candidatos quando as condições de segurança falham, mesmo que uma pontuação agregada melhore.

Rastreabilidade de evidências, responsabilidades de cada papel e critérios de avaliação tratam de questões também presentes no nosso sistema de produção. Nem todos os modelos de pesquisa e fluxos experimentais estão integrados aos produtos lançados.

A implementação e os dados de pesquisa permanecem privados. Esta é uma pesquisa aplicada com modelos existentes; experimentos individuais não comprovam superioridade geral nem prontidão comercial.

Papéis e validação no sistema de produção

Projetos de pesquisa e ferramentas de desenvolvimento

Lançado

MQ Watcher

Em exploração

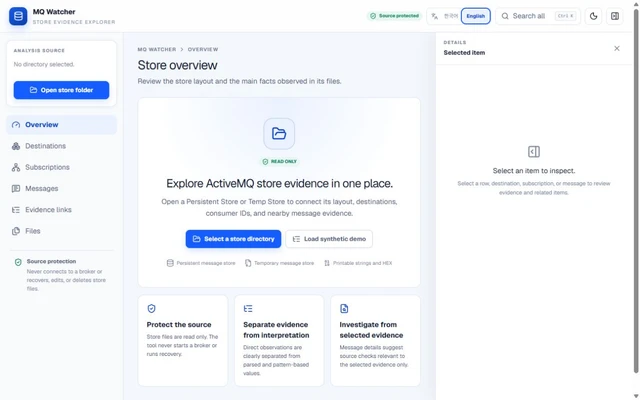
Analisa a estrutura dos diários KahaDB (lotes, cabeçalhos de registro, envelopes de comando e somas de verificação) e conecta evidências relacionadas. Você pode abrir vários armazenamentos em abas, comparar dois instantâneos A/B, rastrear um JMSMessageID exato em todas as evidências, manter notas de incidentes, revisar a retenção dos diários e exportar um pacote de evidências com dados sensíveis ocultados.

Por que isso importa

A ferramenta lê os armazenamentos sem abri-los para escrita, carregar JARs do produto ou iniciar recuperação ou compactação. Isso preserva as evidências investigadas, que podem mudar ao abrir o armazenamento de um broker com o runtime ou o caminho de recuperação errado. A CLI se vincula apenas a 127.0.0.1 e não possui endpoint de upload.

Estado atual

A versão 0.4.0 está disponível no GitHub e inclui rastreamento exato de JMSMessageID. A matriz de compatibilidade documenta as versões e cenários ActiveMQ testados; consulte-a antes de usar a ferramenta em outro formato de armazenamento.

Conhecer o projeto

Em exploração

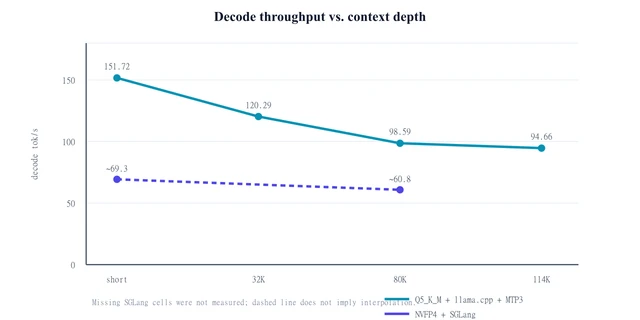
Como uma única RTX 5090 pode apoiar o desenvolvimento local com um grande modelo de linguagem? Estudamos velocidade de inferência, contexto longo e fluxos de programação com Qwen3.8-27B.

Por que isso importa

Os números anteriores de decodificação descrevem as configurações e cargas de trabalho usadas na época. Não são medições de desempenho da configuração atual DFlash2 200k. No desenvolvimento diário, consideramos juntos o tempo de resposta, o tratamento do contexto e a qualidade do trabalho concluído.

Estado atual

Uma configuração de contexto 200k e o uso diário não comprovam um benchmark de profundidade total. Ainda faltam testes comparáveis de precisão em contexto longo e medições de programação de ponta a ponta para a configuração atual.

Conhecer o projeto

Em exploração

Uma ferramenta de escrita consegue manter personagens, eventos anteriores e regras do mundo consistentes ao longo de muitos episódios? Estamos desenvolvendo um sistema que confere o novo texto com o estado registrado da história antes de levá-lo ao próximo episódio.

Por que isso importa

Um modelo de linguagem não tem memória persistente do mundo sobre o qual escreve. Após algumas cenas, a personalidade se desvia, soluções anteriores são esquecidas e a continuidade espacial ou temporal se rompe. Manter o estado de um mundo grande e consistente em uma janela de contexto finita, sem perder a naturalidade da prosa, é a parte difícil.

Estado atual

Esta é uma pesquisa em andamento, não um produto lançado. Compartilharemos mais da abordagem quando estiver estável o suficiente para descrevê-la com precisão.

Conhecer o projeto

Em exploração

Um pequeno modelo executado localmente pode ajudar um engenheiro a interpretar registros de sistemas de mensagens sem recomendar mudanças não verificadas ou destrutivas? Estamos testando métodos de treinamento e avaliação para essa tarefa.

Por que isso importa

Brokers de mensagens empresariais envolvem falhas complexas em cascata: esgotamento de pools de threads, limites de armazenamento do broker, índices de persistência corrompidos e timeouts em cascata. Modelos pequenos tendem a inventar configurações aparentemente plausíveis ou sugerir operações administrativas perigosas sem isolar a causa raiz.

Estado atual

Esta é uma pesquisa aplicada privada. Experimentos com dados públicos e calibração ficam separados das fontes privadas, com resultados de avaliação limitados aos dados e às condições usados.

Conhecer o projeto
Protótipo
  • OSS
  • MIT

Bento

Em exploração

O desenvolvimento abrange navegação de arquivos e pastas, uploads em partes, downloads, pesquisa e links de compartilhamento. Permissões de acesso, gestão da lixeira e administração do armazenamento fazem parte do mesmo projeto, permitindo considerar juntos o gerenciamento de arquivos e a manutenção do armazenamento.

Por que isso importa

Bento é executado em um servidor gerenciado por seu operador. O operador escolhe o armazenamento e administra o acesso, as atualizações e os backups. O projeto inclui um modo de manutenção somente leitura para pausar alterações em arquivos durante trabalhos no armazenamento; o uso normal inclui upload e gerenciamento de arquivos.

Estado atual

Bento está disponível publicamente sob a licença MIT e continua no início do desenvolvimento. A versão v0.1.0 estabelece uma base de prontidão para código aberto, reunindo código-fonte, orientações de contribuição e documentação de manutenção. Não é apresentado como um serviço de armazenamento hospedado e concluído.

Conhecer o projeto

Nossa tecnologia interna de produção

Parte da tecnologia cresce dentro do produto.

Também desenvolvemos um sistema interno de produção para nossos produtos, conectando planejamento, engenharia, criação 2D e 3D, verificação e operação.

Conheça nosso sistema de produção
PRÓXIMO CAPÍTULO

Sobre

Conheça quem está por trás do trabalho.