Investigación y código abierto

Exploración abierta.
Mejores productos.

Investigamos las preguntas detrás de mejores productos y herramientas de producción. Conoce los conceptos y métodos de nuestra investigación de IA especializada, junto con experimentos públicos y herramientas de código abierto.

IA especializada · Investigación aplicada

¿Qué hace confiable a una IA especializada?

Investigamos especialistas de IA que trabajan con conocimiento del área y pruebas. Nuestros experimentos conectan la recuperación de documentos y código, el entrenamiento y la inferencia de modelos, y las herramientas de evaluación, documentando tanto las mejoras como los límites de las fallas.

Investigación interna en curso · Conceptos y métodos compartidos públicamente

  1. 01Pregunta del área
  2. 02Pruebas y ejemplos
  3. 03Experimentos de entrenamiento e inferencia
  4. 04Evaluación con casos reservados y comprobaciones de regresión

Conocimiento del área respaldado por pruebas

¿Hasta dónde podemos rastrear las pruebas detrás de una respuesta?

Estudiamos la recuperación de documentos y código, contrastando las citas con sus fuentes. El conocimiento cambiante sigue accesible mediante recuperación, con un tratamiento explícito de las pruebas ausentes y las acciones riesgosas.
Aprender y transferir habilidades especializadas

¿Pueden los flujos de diagnóstico aprendidos conservar un criterio sólido?

Revisamos ejemplos estructurados generados por modelos docentes y experimentamos con el ajuste fino y la destilación de modelos alumnos. Separamos los datos de entrenamiento y evaluación, con comparaciones antes y después del entrenamiento y entre formatos de despliegue.

Evaluación que revela fallas

¿Una mejora aparente introduce nuevas fallas?

Los casos reservados, los contraejemplos y las comprobaciones de regresión examinan la precisión de las pruebas y el manejo de la incertidumbre. Nuestros métodos impiden promover candidatos cuando no se cumplen las condiciones de seguridad, incluso si mejora una puntuación global.

La trazabilidad de las pruebas, las responsabilidades de cada rol y los criterios de evaluación abordan preguntas compartidas con nuestro sistema de producción. No todos los modelos de investigación y flujos experimentales están integrados en productos publicados.

La implementación y los datos de investigación siguen siendo privados. Se trata de investigación aplicada con modelos existentes; los experimentos individuales no demuestran superioridad general ni preparación comercial.

Roles y validación en el sistema de producción

Proyectos de investigación y herramientas de desarrollo

Publicado

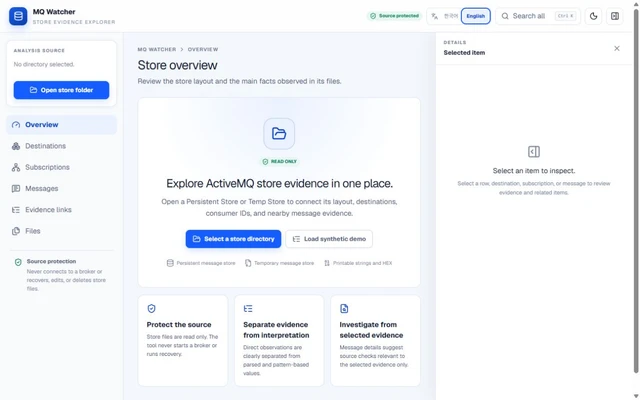
MQ Watcher

En exploración

Analiza la estructura de los diarios de KahaDB (lotes, encabezados de registros, envolturas de comandos y sumas de verificación) y vincula pruebas relacionadas. Puedes abrir varios almacenes en pestañas, comparar dos instantáneas A/B, rastrear un JMSMessageID exacto en todas las pruebas del almacén, guardar notas de incidentes, revisar la retención de diarios y exportar un paquete de pruebas con datos sensibles ocultos.

Por qué importa

La herramienta lee los almacenes sin abrirlos para escritura, cargar JAR del producto ni iniciar recuperación o compactación. Esto conserva las pruebas investigadas, que pueden cambiar al abrir el almacén de un broker con un entorno de ejecución o una ruta de recuperación incorrectos. La CLI solo se vincula a 127.0.0.1 y no tiene un endpoint de carga.

Estado actual

La versión 0.4.0 está disponible en GitHub e incluye rastreo exacto de JMSMessageID. La matriz de compatibilidad documenta las versiones y los escenarios de ActiveMQ probados; revísala antes de usar la herramienta con otro formato de almacén.

Conocer el proyecto

En exploración

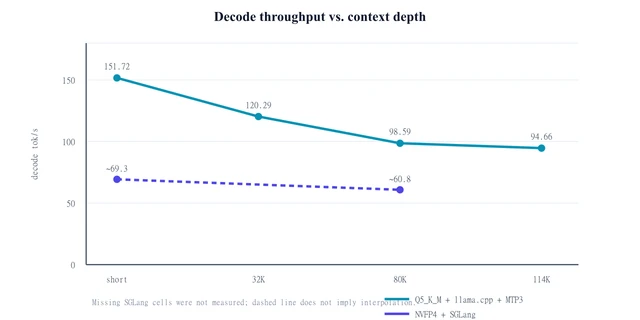
¿Cómo puede una sola RTX 5090 apoyar el desarrollo local con un modelo de lenguaje grande? Estudiamos la velocidad de inferencia, el contexto largo y los flujos de programación con Qwen3.8-27B.

Por qué importa

Las cifras anteriores de decodificación describen las configuraciones y cargas de trabajo usadas entonces. No son mediciones del rendimiento de la configuración actual de DFlash2 200k. En el desarrollo diario consideramos juntos el tiempo de respuesta, el manejo del contexto y la calidad del trabajo terminado.

Estado actual

Una configuración de contexto de 200k y el uso cotidiano no constituyen una evaluación de profundidad completa. Aún faltan pruebas comparables de precisión con contexto largo y mediciones de programación de principio a fin para la configuración actual.

Conocer el proyecto

En exploración

¿Puede una herramienta de escritura mantener coherentes los personajes, los eventos pasados y las reglas del mundo a lo largo de muchos episodios? Desarrollamos un sistema que contrasta el texto nuevo con el estado registrado de la historia antes de incorporarlo al siguiente episodio.

Por qué importa

Un modelo de lenguaje no tiene memoria persistente del mundo sobre el que escribe. Tras algunas escenas, la personalidad cambia, se olvidan resoluciones anteriores y se rompe la continuidad espacial o temporal. Mantener el estado de un mundo grande y coherente en una ventana de contexto finita, sin perder la naturalidad de la prosa, es la parte difícil.

Estado actual

Es una investigación en curso, no un producto publicado. Compartiremos más del enfoque cuando sea lo bastante estable para describirlo con precisión.

Conocer el proyecto

En exploración

¿Puede un modelo pequeño ejecutado localmente ayudar a un ingeniero a interpretar registros de sistemas de mensajería sin recomendar cambios no verificados o destructivos? Probamos métodos de entrenamiento y evaluación para esa tarea.

Por qué importa

Los brokers de mensajes empresariales presentan cascadas complejas de fallas: agotamiento de grupos de hilos, límites del almacén del broker, índices de persistencia corruptos y tiempos de espera en cascada. Los modelos pequeños tienden a inventar configuraciones aparentemente plausibles o sugerir operaciones administrativas peligrosas sin aislar la causa raíz.

Estado actual

Es investigación aplicada privada. Los experimentos con datos públicos y la calibración se mantienen separados de las fuentes privadas, con resultados de evaluación limitados a los datos y las condiciones usados.

Conocer el proyecto
Prototipo
  • OSS
  • MIT

Bento

En exploración

El desarrollo incluye navegación de archivos y carpetas, cargas por partes, descargas, búsqueda y enlaces para compartir. Los permisos de acceso, la gestión de la papelera y la administración del almacenamiento forman parte del mismo proyecto, para considerar juntos el manejo de archivos y el mantenimiento del almacenamiento.

Por qué importa

Bento se ejecuta en un servidor gestionado por su operador. El operador elige el almacenamiento y administra el acceso, las actualizaciones y las copias de seguridad. El diseño incluye un modo de mantenimiento de solo lectura para pausar cambios en archivos durante trabajos en el almacenamiento; el uso normal incluye cargar y gestionar archivos.

Estado actual

Bento está disponible públicamente bajo la licencia MIT y sigue en desarrollo inicial. La versión v0.1.0 establece una base de preparación para código abierto, reuniendo el código fuente, las pautas de contribución y la documentación de mantenimiento. No se presenta como un servicio de almacenamiento alojado y terminado.

Conocer el proyecto

Nuestra tecnología interna de producción

Parte de la tecnología crece dentro del producto.

También desarrollamos un sistema interno de producción para nuestros productos, conectando planificación, ingeniería, creación 2D y 3D, verificación y operación.

Conoce nuestro sistema de producción
PRÓXIMO CAPÍTULO

Acerca de

Conoce a quienes están detrás del trabajo.