以證據為基礎的領域知識
能追溯回答背後多少證據?
我們研究文件與程式碼檢索,將引用對照原始來源。變動的知識透過檢索保持可用,並明確處理缺乏證據及高風險操作。
研究與開放原始碼
我們探討改善產品與製作工具背後的問題。探索專業AI研究的概念與方法,以及公開實驗和開放原始碼工具。
專業AI · 應用研究
研究運用領域知識與證據的專業AI。實驗串連文件和程式碼檢索、模型訓練與推論、評估工具,同時記錄改善和失敗界線。
持續中的內部研究 · 公開概念與方法
能追溯回答背後多少證據?
我們研究文件與程式碼檢索,將引用對照原始來源。變動的知識透過檢索保持可用,並明確處理缺乏證據及高風險操作。
學到的診斷流程能保留可靠判斷嗎?
審閱教師模型產生的結構化範例,實驗學生模型微調與蒸餾。訓練和評估資料分開,比較訓練前後及各部署格式。
看似改善,是否帶來新的失敗?
保留案例、反例及迴歸檢查驗證證據準確性與不確定性的處理。即使總分提高,未通過安全條件的候選也不會獲得晉升。
證據可追溯性、角色責任及評估標準,也回應製作系統的共同問題。研究模型與實驗流程並非全數整合至已推出的產品。
實作及研究資料不公開。這是運用既有模型的應用研究;個別實驗不代表普遍優勢或已可商用。
製作系統中的角色與驗證探索中
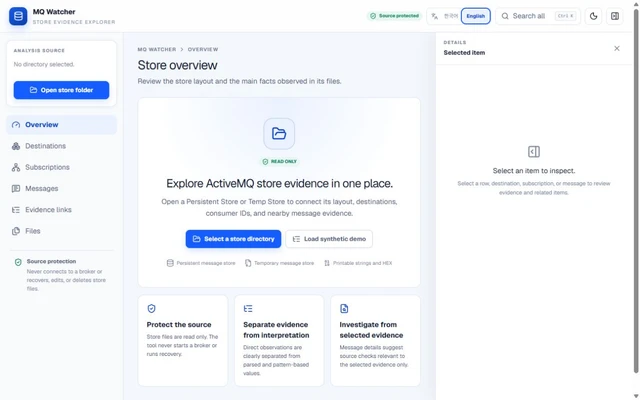
解析KahaDB日誌結構(批次、紀錄標頭、命令封裝及校驗碼),連結相關證據。可在分頁開啟多個儲存庫、比較兩份快照A/B、以精確JMSMessageID追蹤所有證據、記錄事件筆記、檢查日誌保留狀況並匯出已遮蔽敏感資訊的證據包。
為何重要
工具讀取儲存庫時不以寫入模式開啟、不載入產品JAR,也不開始復原或壓縮,保護調查證據,避免因錯誤執行環境或復原路徑而改變。CLI只綁定127.0.0.1,沒有上傳端點。
目前狀態
GitHub已提供0.4.0版本,包含精確JMSMessageID追蹤。相容性矩陣列出測試過的ActiveMQ版本與情境,使用不同格式前請先確認。
探索中
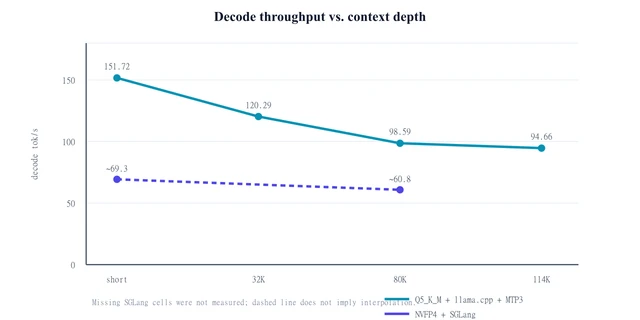
單張RTX 5090如何支援大型語言模型的本機開發?我們用Qwen3.8-27B研究推論速度、長上下文及程式開發流程。
為何重要
先前解碼數據描述當時的設定與工作負載,並非目前DFlash2 200k設定的效能測量。日常開發會一併考慮回應時間、上下文處理及成品品質。
目前狀態
200k上下文設定與日常使用不等於完整深度的基準測試。目前設定的可比較長上下文準確性與端到端程式開發測量仍待完成。
探索中
寫作工具能否跨多集保持人物、過去事件及世界規則一致?我們正在開發系統,在將新文字帶入下一集前,先對照故事已記錄的狀態。
為何重要
語言模型不會永久記住正在撰寫的世界。幾個場景後,性格漂移、先前結局遭遺忘,空間或時間連續性中斷。難點在有限上下文中維持龐大且一致的世界狀態,同時產生自然文字。
目前狀態
這是持續研究,並非已推出產品。待方法穩定到能準確描述時,會分享更多內容。
探索中
本機小模型能否協助工程師解讀訊息系統日誌,又不建議未驗證或破壞性變更?我們正在測試此任務的訓練與評估方法。
為何重要
企業訊息代理涉及複雜連鎖故障,包括執行緒池耗盡、儲存限制、持久化索引損壞及連鎖逾時。小語言模型常虛構看似合理的設定,或未確認根因就建議危險管理操作。
目前狀態
這是非公開應用研究。公開資料實驗及校準與私人來源分開,評估結果限定於使用的資料和條件。
探索中
開發涵蓋檔案與資料夾瀏覽、分塊上傳、下載、搜尋及分享連結。存取權限、垃圾桶、儲存管理也屬於同一專案,以兼顧檔案管理與儲存維護。
為何重要
Bento在營運者管理的伺服器運作。營運者選擇儲存空間並管理存取、更新及備份。設計包含唯讀維護模式,可在儲存維護時暫停檔案變更;一般使用可上傳及管理檔案。
目前狀態
Bento依MIT授權公開,仍在早期開發。v0.1.0是開放原始碼準備基準,整合程式碼、貢獻指引及維護文件,並非完成的代管儲存服務。
內部製作技術
我們也為自有產品開發內部製作系統,串連規劃、工程、2D和3D創作、驗證與營運。
了解製作系統